
النتيجة أولاً
اللوحات السعودية هي الأصعب بين صيغ اللوحات الخليجية الست. كل لوحة تحمل رقم التسجيل نفسه مرتين — مرة بالعربية ومرة باللاتينية — والنظام الذي يقرأ نصاً واحداً فقط يتخلّى عن نصف الدليل المتاح على كل مركبة.
نحن نقرأ السطرين معاً. لا بتحويل اللاتيني إلى عربي عبر جدول مقابلة — وهو ما يعنيه «دعم العربية» عادةً — بل باكتشاف الحروف العربية على اللوحة نفسها، بشكل مستقل.
أخذنا 106 صور لوحات من تصوير مروري حقيقي لم يره نظامنا من قبل، وطلبنا من إنسان قراءة كل صورة، ثم قِسنا نص اللوحة الكامل الذي تعيده واجهتنا البرمجية — أرقاماً وحروفاً، صحيحاً تماماً أو خطأ.
- العربية تُقرأ بمستوى اللاتينية — 89.1% في الأرقام لكلا السطرين، و80.4% مقابل 78.3% في الحروف، حيث تكون العربية مقروءة فعلياً لا محوَّلة
- قراءة السطرين ترفع السقف — الحروف الصحيحة حاضرة في 84.8% من الإطارات مقابل 78.3% من السطر اللاتيني وحده، لأن النصّين يفشلان على إطارات مختلفة. لا ندّعي هذا الرقم كدقة لنا؛ ما نقدّمه فعلياً هو الاختلاف بين السطرين
- 8 من 8 إطارات قُرئت بلا خطأ واحد عند الدقة التي توفّرها كاميرا ANPR مخصّصة (150 بكسل أو أكثر عرضاً للوحة) — أرقاماً وحروفاً
- 61.9% من المركبات صحيحة بالكامل عبر المجموعة كلها؛ و81.0% في الأرقام وحدها
وهذه هي الأرقام التي يُغفلها معظم المورّدين. على الإطارات المفردة — إطار واحد في كل مرة، بلا تصويت عبر عدة إطارات، وبوسيط عرض لوحة لا يتجاوز 82 بكسل:
| إطار مفرد، الـ106 كلها | صحيح |
|---|---|
| الأرقام فقط | 71.7% |
| الحروف فقط | 57.3% |
| اللوحة الكاملة | 50.0% |
الحروف هي النصف الأضعف، ولن ندّعي غير ذلك. فهي الذيل الرفيع في أي مجموعة لوحات — الحروف النادرة تظهر بجزء يسير من تكرار رقم شائع — وسدّ هذه الفجوة هو ما يذهب إليه جهد التوسيم لدينا حالياً.
ماذا يعني «صحيح» هنا. سجّل مراجعنا كل لوحة كما يُقرأ التسجيل بالحروف اللاتينية — أرقام مع حروف لاتينية — لذلك فإن أرقام الأرقام/الحروف/اللوحة الكاملة أعلاه مُقاسة مقابل السطر اللاتيني. أما السطر العربي فيُقاس منفصلاً في ما يلي، مقابل القراءة البشرية نفسها، وهو ممكن لأن الأرقام العربية الشرقية تقابل الأرقام مقابلة واحد لواحد.
كيف تُقرأ الوحدات. المجموعة هي 106 إطارات تغطي 42 مركبة مختلفة — السيارة المتتبَّعة تنتج عدة إطارات للوحة نفسها. أي تشغيل حقيقي يصوّت عبر تلك الإطارات، ولهذا فإن الدقة لكل مركبة (61.9%) أعلى من الدقة لكل إطار (50.0%).
نبدأ بأضعف الأرقام عن قصد. السؤال المهم في التعرف على اللوحات ليس أبداً «كم دقتكم». بل تحت أي ظروف — ورقم دقة بلا ظروفه المرفقة هو تسويق لا قياس.
لماذا يستحق السطر العربي أن يُقرأ
اللوحة السعودية ثنائية اللغة بحكم النظام — التسجيل نفسه بالعربية أعلى وباللاتينية أسفل. معظم قارئات اللوحات تعالج اللاتيني ثم تصنع العربي بتحويله عبر جدول الحروف الرسمي. هذا يُنتج نصاً عربياً معقولاً على كل لوحة ولا يخبرك بشيء، لأنه بحث في جدول لا قراءة. أعطِ نظاماً كهذا لوحةً أُخطئ في قراءة سطرها اللاتيني وسيعطيك ترجمة عربية واثقة للخطأ نفسه.
نحن نكتشف الحروف العربية على اللوحة بشكل مستقل. وهذه مشكلة بيانات قبل أن تكون مشكلة نموذج.
قراءة العربية أصلاً تتطلب أن يكون أحدهم قد رسم إطاراً حول عشرات الآلاف من الحروف العربية المفردة، على لوحات خليجية حقيقية، وفي الظروف التي تُصوَّر فيها تلك اللوحات فعلاً — وهج، وضبابية حركة، وزوايا مائلة، وليل. لا توجد مجموعة بيانات عامة لهذا ولا طريق مختصر إليه: إما أن تطلب ذلك التوسيم وتموّله، أو لا تملك هذه القدرة. تلك المجموعة هي أصعب جزء في هذا النظام على التكرار، وهي سبب وجود الأرقام العربية أعلاه من الأساس.
وهذا ما تحقّقه، مُقاساً مقابل القراءة البشرية نفسها على الإطارات التي قُرئت فيها العربية فعلياً من اللوحة:
| السطر اللاتيني | السطر العربي | حاضر في سطر واحد على الأقل (السقف) | |
|---|---|---|---|
| الأرقام صحيحة | 89.1% | 89.1% | — |
| الحروف صحيحة | 78.3% | 80.4% | 84.8% |
السطر العربي ليس الأضعف. فهو يوازي اللاتيني في الأرقام ويتقدّم عليه قليلاً في الحروف. والأهم أن النصّين يفشلان على إطارات مختلفة: الحروف الصحيحة حاضرة في سطر واحد على الأقل في 84.8%، مقابل 78.3% للاتيني وحده. والأمر نفسه في الأرقام — 71.7% من اللاتيني، و70.8% من العربي، و76.4% من سطر واحد على الأقل.
ولنكن واضحين بشأن ما يمثّله رقم 84.8%. إنه سقف، لا دقتنا. اختيار السطر الصحيح في كل مرة يتطلب معرفة أي السطرين صحيح، ولا نملك قاعدة تفعل ذلك بموثوقية — فالسطر الأعلى ثقةً ليس بالضرورة الصحيح. لذلك لا ندّعي 84.8%.
ما نقدّمه بدلاً من ذلك هو الاختلاف نفسه. في الإطارات التي يتعارض فيها السطران، نخبرك بأنهما متعارضان بدل أن نعيد أحدهما بصمت. القارئ أحادي النص لا يستطيع تقديم ذلك عند أي عتبة ثقة، لأنه لم يمتلك القراءة الثانية أصلاً. المعلومة الإضافية حقيقية؛ ونحن نُظهرها بدل ادّعاء قدرتنا على حسمها تلقائياً.
كيف يمكن قياس الحروف العربية أصلاً: تستخدم اللوحات السعودية أبجدية رسمية من 17 حرفاً، لكل حرف لاتيني مسموح فيها مقابل عربي واحد بالضبط، لذا يمكن التعبير عن القراءة اللاتينية للإنسان كمرجعية عربية دون سؤال النموذج عن أي شيء. الفخّ هنا هو الدوران المنطقي — فلو كان نظامنا قد حوّل السطر اللاتيني لإنتاج عربيته، لكان قياس ذلك مقابل الجدول نفسه تقييماً لجدول بحث في مواجهة نفسه. لذلك نقيس فقط الإطارات التي اكتُشفت فيها العربية فعلياً، ونستطيع تمييزها لأن كل نص عربي نعيده موسوم بأنه مقروء أو مشتق. تلك المجموعة الفرعية (46 إطاراً، وسيط 99 بكسل) تميل إلى صور أفضل من المجموعة عموماً، فقارن السطرين ببعضهما لا بالأرقام الرئيسية.
ما لا يخبرك به أحد: الدقة البصرية تحسم كل شيء تقريباً
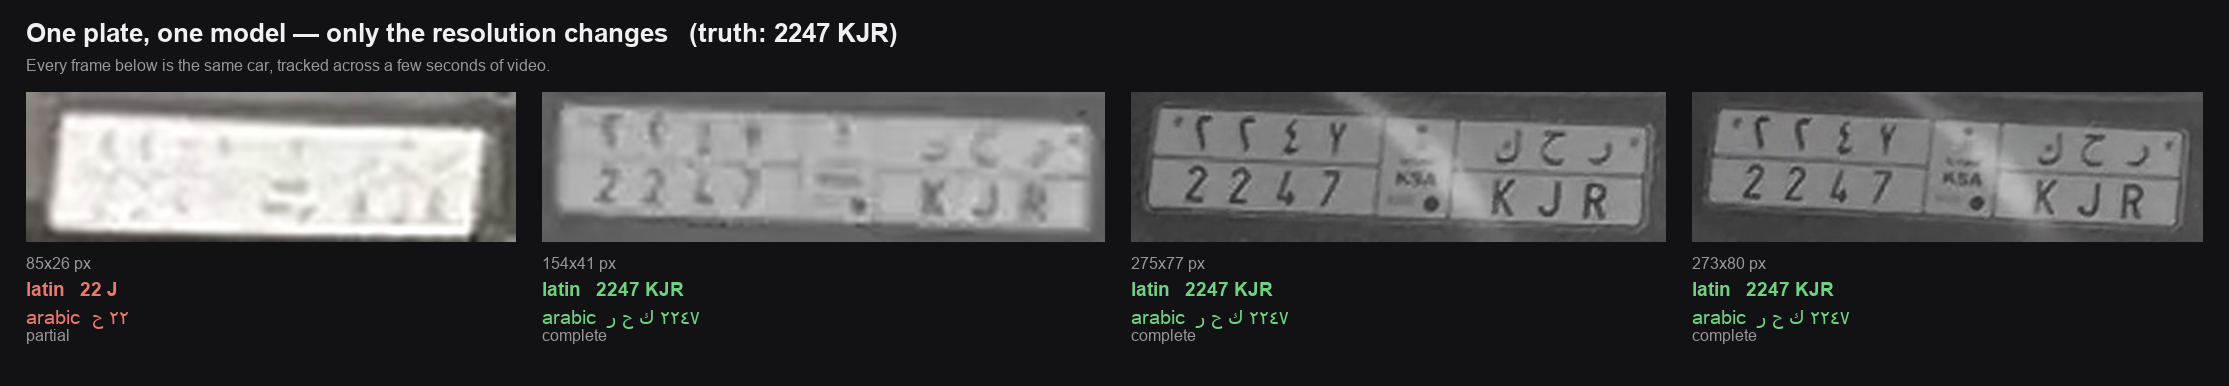
هذه لوحة واحدة، ونموذج واحد، ولا يتغير شيء سوى عدد البكسلات التي وفّرتها الكاميرا.
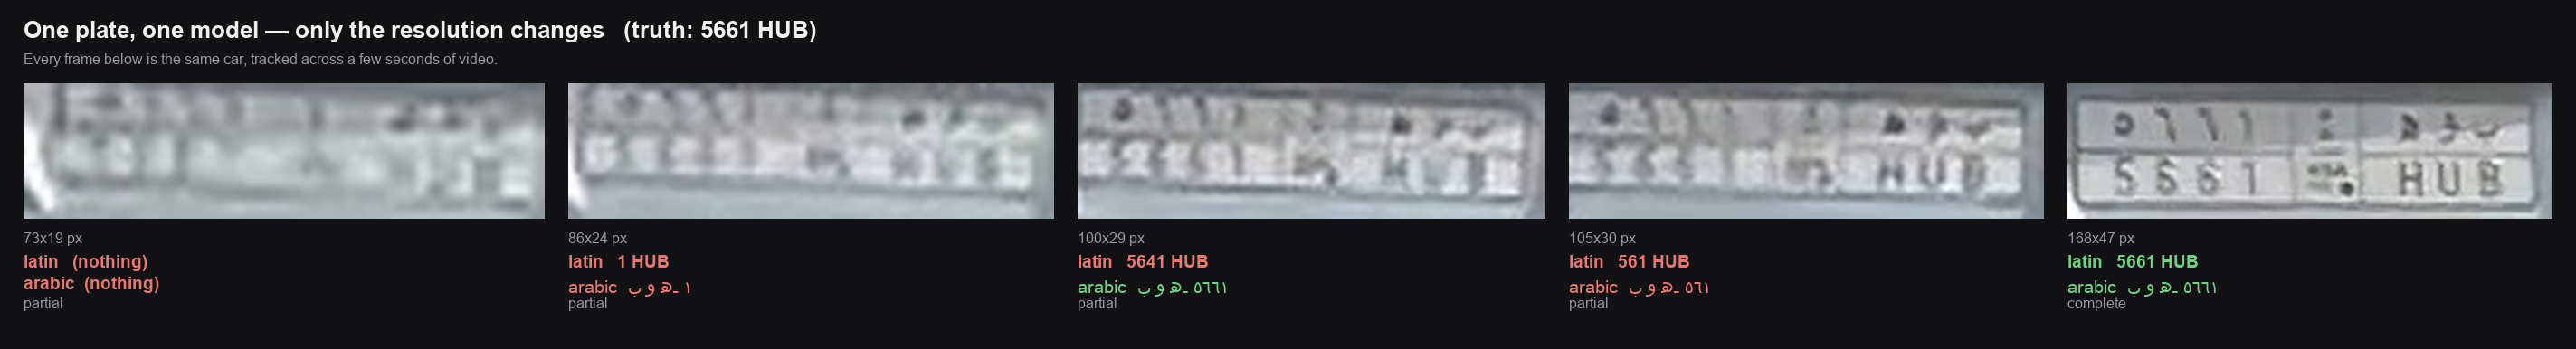
عند عرض 73 بكسل لا يعيد النظام شيئاً. وعند 86 بكسل يمسك بالحروف. وعند 100 بكسل يمسك بمعظم الأرقام. وعند 168 بكسل يكون صحيحاً ببساطة. النموذج واحد في الإطارات الخمسة جميعها. كل ما في الأمر أن السيارة اقتربت.
ولنفكّك المعيار كله بالطريقة نفسها:
| عرض اللوحة | الإطارات | الأرقام | الحروف (العدد) | اللوحة الكاملة |
|---|---|---|---|---|
| أقل من 80 بكسل | 48 | 66.7% | 16.7% (36) | 27.1% |
| 80–100 بكسل | 32 | 68.8% | 70.4% (27) | 56.2% |
| 100–150 بكسل | 18 | 77.8% | 100% (18) | 77.8% |
| 150 بكسل فأكثر | 8 | 100% | 100% (8) | 8 من 8 |
تُقاس الحروف فقط على اللوحات التي يتضمن تسجيلها حروفاً — 89 من أصل 106؛ والبقية وعددها 17 أرقام فقط، ولهذا لعمود الحروف مقامه الخاص. وهذا يفسّر أيضاً صفّين قد يبدوان خاطئين: اللوحة الكاملة (27.1%) تتجاوز الحروف (16.7%) في الشريحة الأولى لأن اللوحات الرقمية الخالصة تُحتسب ضمن اللوحة الكاملة لا ضمن الحروف؛ و100% في الحروف عند 100–150 بكسل تجاور 77.8% للوحة الكاملة لأن الأرقام، لا الحروف، هي ما يفشل هناك. والصفّان الأخيران يقومان على عدد صغير — فاعتبرهما «لم تُرصد أخطاء» لا معدلات.
دقة اللوحة الكاملة تسير 27% ← 56% ← 78% ← 100% كلما ازداد عرض اللوحة. والحروف تنهار بأشدّ صورة عند الدقة المنخفضة — 16.7% تحت 80 بكسل — وهو ما يجرّ رقم اللوحة الكاملة إلى الأسفل، وهو بالضبط ما تتوقعه، لأن الحرف يحمل تفاصيل شكلية أكثر من الرقم.
وهناك تحفّظان نفضّل ذكرهما على أن تكتشفهما بنفسك. ثمانية إطارات لا تكفي لإثبات «100%»، وتلك الثمانية تغطي ثلاث مركبات مختلفة فقط، فاعتبر الصف الأعلى لم تُرصد فيه أخطاء بدل أن يكون معدلاً. أما ما تثبته الـ106 إطاراً عبر الشرائح الأربع فهو علاقة اطّرادية نظيفة بين عرض اللوحة والدقة، بلا انعكاس في أي موضع وبلا خطأ واحد فوق 150 بكسل.
ولهذا فإن مجموعة اختبارنا قاسية عن عمد. ثلاثة أرباعها تحت عرض 100 بكسل؛ و92% منها تحت 150 بكسل. هذه قصاصات من فيديو عام على مسافة — لا من كاميرا موضوعة لالتقاط اللوحات. الكاميرا بدقة 1080p المواصَفة لأنظمة ANPR تضع 150–300 بكسل عبر اللوحة كأمر روتيني. وهذا هو الغرض من المواصفة أصلاً.
فالأمران صحيحان معاً، ونفضّل نشرهما معاً: رقمنا على المجموعة كلها للإطار المفرد هو 50% للوحة الكاملة، وهو رقم تهيمن عليه صور لا يقبلها أي مركِّب أنظمة ANPR. وإذا كنت تضع مواصفات تشغيل، فإن عرض اللوحة عند نقطة الالتقاط سيحرّك دقتك أكثر من نموذج أي مورّد.
ما الذي نفعله بشكل مختلف
نخبرك حين يتعارض السطران
قراءة النصّين تمنحك تحقّقاً متقاطعاً لا يستطيع تحويل سطر إلى آخر أن ينتجه. فالنص المحوَّل مشتق من القراءة اللاتينية، أي أنه يوافقها بحكم البناء — لا يمكنه أن يناقضها، ما يعني أنه لا يمكنه أن ينذرك. أما قراءتان مستقلتان فتستطيعان. عبر عيّنة أوسع من اللوحات السعودية، يتعارض سطرانا في 11% — أي أن أحدهما على الأقل خاطئ — وفي 1.5% يكون السطر العربي هو الوحيد القابل للقراءة.
صحيح أن السطر اللاتيني يحمل الثقة الأعلى في الغالب، لكن الثقة ليست الصواب: على أي لوحة بعينها، ارتفاع الدرجة في سطر لا يخبرك بشيء موثوق عن أيّهما الصحيح. لذلك لا نختار فائزاً بصمت. بل نُظهر التعارض.
في أنظمة ANPR، الفشل المكلف هو الصامت — لوحة خاطئة تعني أن المركبة الخطأ تُحاسَب أو تُرصَد ولا يكتشف أحد ذلك. القارئ أحادي النص يعيد جواباً على تلك الـ11% دون أي إشارة إلى وجود خلل. أما تعارض معلَن فيعني إعادة محاولة، أو تصعيداً، أو مراجعة بشرية — وكلها رخيصة بالمقارنة.
عربية تثق بها، أو تعرف ألّا تثق بها
كل نص عربي نعيده موسوم بـ detected أو mixed أو transliterated، فتعرف دائماً إن كنت تنظر إلى حروف قُرئت من اللوحة أم إلى حروف محوَّلة عن السطر اللاتيني. والمورّدون الذين يحوّلون بصمت لا يتركون لك وسيلة للتمييز.
يتدهور إلى نقص، لا إلى اختلاق
أمر يستحق المعرفة إن كنت تحاسب أو تطبّق أنظمة بناءً على هذه القراءات: فحصنا ما يفعله النظام على لوحات حديّة فعلاً.
بمعزل عن الـ106 إطاراً المُقاسة، نحّى مراجعنا جانباً 8 قصاصات لم يستطع قراءتها. وعند إعادة الفحص تبيّن أن واحدة منها على الأقل كانت مقروءة — اللوحة نفسها واضحة في إطار فيديو مجاور — وهذا بالضبط سبب استبعاد هذه الثمانية من كل رقم دقة على هذه الصفحة. فمرجعيتها ليست موثوقة بما يكفي للقياس عليها. وهي مذكورة هنا فقط كفحص للسلوك، وهو ما لا يتوقف على معرفة الجواب الصحيح.
على تلك الثمانية أعاد النظام لا شيء في 5 ونصاً جزئياً في 3 — 29 و32 وUU. وكل حرف أو رقم أعاده كان موجوداً فعلاً على اللوحة؛ و29 هي الأرقام الأولى الصحيحة لتلك اللوحة كما تظهر بوضوح في الإطار المجاور.
لم تُنتج أي من الثمانية نصاً بهيئة لوحة لا صلة له بما على الزجاج. وهذا هو نمط الفشل المهم: نظام يخترع تسجيلاً معقولاً لصورة غير مقروءة سيحاسب المركبة الخطأ ولا يترك لك وسيلة لمعرفة ذلك. أما أن يعيد أقل، أو ألّا يعيد شيئاً، فهذا قابل للتدارك — تعيد المحاولة، أو تصعّد، أو ترسلها إلى إنسان.
ثقة لكل حرف يمكنك البناء عليها
كل حرف نكتشفه يعود بدرجة ثقته الخاصة وإطاره المحيط، لا بدرجة إجمالية واحدة للوحة كلها. فإن كان رقم واحد ضعيفاً، تستطيع رؤية أيّها وتقرر ما تفعله حياله. ولا نُرفق أبداً درجة ثقة بحرف لم نكتشفه فعلاً — فالحرف المحوَّل لا قراءة خلفه، واختلاق درجة له يقدّم تخميناً في صورة دليل.
معالجة صحيحة لكل دولة من دول الخليج الست
أعراف حروف اللوحات تختلف فعلاً بين الدول — حرف H في عُمان هو J في السعودية، وM في عُمان هو Z في السعودية — كما أن اللوحات القطرية والكويتية والبحرينية لا تحمل حروفاً عربية للتحويل أصلاً. نحن نطبّق العرف الصحيح لكل دولة بدل جدول واحد يُفرض في كل مكان.
كيف نعرف أن هذه الأرقام حقيقية
ثلاثة التزامات، نشجّعك على مطالبة أي مورّد بها:
مجموعة الاختبار تم التحقق من أنها غير مرئية للنموذج، لا افتراض ذلك. كل إطار من الـ106 خضع لمطابقة بصمة محتوى مقابل مجموعة تدريبنا كاملة قبل القياس، مع تأكيد انعدام التطابق قبل إنتاج أي رقم. أسماء الملفات لا تثبت شيئاً — الصورة المكررة باسم مختلف تبقى مكررة.
المرجعية بشرية، والقياس من الطرف إلى الطرف. قرأ شخص كل لوحة. ونحن نقيس نص اللوحة المُجمَّع الذي تعيده واجهتنا فعلاً للعميل، لا درجة نموذج داخلية. فالمقاييس الداخلية قد تتحسّن بينما يسوء المخرَج الذي يراه العميل؛ ولهذا بالضبط توقفنا عن اعتبارها بوابة إصدار.
النموذج المرشّح الذي لا يتفوق على القائم لا يُطرح. قبل النظر في أي نموذج مُعاد تدريبه، نقيس أداء النموذج الموجود في الإنتاج حالياً على البيانات المحجوزة نفسها. وبدون تلك المقارنة لا توجد عتبة تقول «هذا فشل» — بل أرقام تبدو معقولة بمعزل عن أي شيء.
وهذا ليس افتراضاً. رفضنا مرشّحاً سجّلت أفضل نقطة تحقّق فيه أقل من النموذج الذي انطلق منه — بينما بدت كل مؤشرات التدريب سليمة طوال الوقت. لم يُطرح، لأن المقارنة موجودة.
ولهذا نحن مرتاحون لنشر رقم الـ50%.
ثلاثة أسئلة اطرحها على أي مورّد لتقنية قراءة اللوحات
ونحن منهم. كل سؤال منها يمكن الإجابة عنه بجملة واحدة من فريق يقيس، ويصعب المراوغة فيه على فريق لا يقيس.
1. عند أي دقة للوحة تحقق رقم الدقة هذا؟ الدقة بلا توزيع لعرض اللوحة ليست رقماً. أرقامنا للوحة الكاملة: 27% تحت 80 بكسل، و56% عند 80–100، و78% عند 100–150، وبلا أخطاء فوق 150 بكسل. اطلب الشرائح، لا المتوسط.
2. ما مرجعيتكم، وهل رآها النموذج من قبل؟ «محجوزة» مجرد ادّعاء. أما مرجعيتنا: 106 إطارات تغطي 42 مركبة مختلفة، قرأها إنسان، وخضعت لمطابقة بصمة محتوى مقابل مجموعة التدريب كاملة مع تأكيد انعدام التطابق قبل القياس.
3. ماذا حدث لآخر نموذج مرشّح لم يُطرح؟ الفريق الذي لم يرفض نموذجاً قط لم تكن لديه بوابة قط. فريقنا رفض نموذجاً سجّلت أفضل نقطة تحقّق فيه أقل من النموذج الذي انطلق منه — واكتُشف ذلك لأننا نقيس النموذج القائم على البيانات المحجوزة نفسها قبل بدء التدريب.
وإن أجاب مورّد عن الأول دون الثاني والثالث، فقد تعلّمت شيئاً مفيداً عن طريقته في التقييم.
جرّبه على لوحاتك أنت
كل ما سبق هو تصويرنا ومراجعنا. ولا ينبغي أن يُطلب منك تصديق ذلك على عواهنه.
جرّبه الآن. أفلِت صورة لوحة في التجربة أدناه وستستعيد ما تعيده الواجهة البرمجية — سطري النص كليهما، والثقة لكل حرف، وما إذا كان السطران متوافقين. كما يخبرك بعرض اللوحة في صورتك وأي شريحة دقة تقع فيها، لتقرأ النتيجة مقابل الجدول أعلاه بدل التخمين إن كانت القراءة السيئة بسبب النموذج أم بسبب البكسلات. هذا التمييز هو جوهر هذا المقال كله، ورؤيته على تصويرك أنت أسهل من رؤيتها على تصويرنا.
جرّبها الآن
اختر ما تريد كشفه، ثم ارفع صورة أو اختر عيّنة. لا يلزم التسجيل.
ماذا تريد أن تجرّب؟
اقرأ رقم لوحة السيارة فقط - الخيار الأسرع.
ارفع صورة
اضغط لالتقاط صورة أو اختيارها
اسحب صورة وأفلتها هنا، أو
استعرض الملفاتJPEG أو PNG أو WebP - حتى 10 ميغابايت
النتيجة
ارفع صورة وستظهر النتيجة هنا
أو جرّب سيارة جاهزة:
لا حاجة لحساب، و10 صور يومياً لكل عنوان IP. وإن أردت تشغيل عيّنة حقيقية بدل فحص عابر، سجّل حساباً وأول 100 قراءة مجانية — الواجهة نفسها، والاستجابة نفسها، وبلا بطاقة.
ثم شغّله بحجم حقيقي. شحن المحفظة بمبلغ 100 دولار يغطي 10,000 قراءة شهرياً — يكفي لوضع النظام أمام بثّ كاميرا حيّ لفترة بدل مجلد عيّنات، وهي الطريقة الوحيدة لمعرفة كيف يتصرّف توزيع عرض اللوحات لديك أنت.
أو أرسل لنا التصوير ونتولّى نحن العمل. راسلنا على [email protected] بما يصل إلى 200 إطار من كاميراتك ومعها أي مرجعية لديك — ولو قائمة جزئية بلوحات تعرفها سلفاً. سنشغّل عليها المعيار نفسه الوارد في هذا المقال بالضبط ونعيد لك التفصيل الكامل: دقة اللوحة الكاملة والدقة لكل نص، وشرائح الدقة البصرية، والإطارات التي تعارض فيها السطران، وكل قراءة أخطأنا فيها مع الصورة مرفقة. المدة بضعة أيام، وبلا تكلفة، وتحتفظ بالنتائج سواء اشتريت شيئاً أم لا.
وإن جاءت النتيجة أسوأ من الأرقام أعلاه، فسترى بالضبط لماذا. على معيارنا نحن، فسّر عرض اللوحة من التباين أكثر من أي عامل آخر قِسناه — 27% في أسفل المدى مقابل انعدام الأخطاء في أعلاه. توقّع أن يكون عمود الدقة البصرية أول موضع يستحق النظر لدى بياناتك.
وإن كانت البيانات لا يمكن أن تغادر مبناك. لدى جهات الضبط والجهات الحكومية ومشغّلي المواقف في الخليج، تخضع بيانات اللوحات كثيراً لقواعد توطين تجعل أي واجهة مستضافة خياراً غير وارد مهما كانت جودة قراءتها. نحن نرخّص المسار الكامل للتركيب داخل مقرّك على خوادمك، وبلا حدود على عدد القراءات — النماذج نفسها، والواجهة نفسها، تعمل داخل شبكتك دون أن يغادرها شيء. إن كان هذا قيدك، فاذكره في أول رسالة وسننتقل إليه مباشرة.
ANPR.software تبني أنظمة التعرف على لوحات المركبات لصيغ اللوحات الخليجية — ست دول، ولوحات سعودية ثنائية اللغة، وأعراف عربية خاصة بكل دولة، وقراءة أصلية للحروف العربية، وثقة لكل حرف يمكنك البناء عليها.